Ringkasan Hasil Claude vs Gemini
Mana yang lebih baik antara Claude dan Gemini? Jawabannya bergantung pada tugas yang Anda kerjakan. Karena itu, untuk pembaruan artikel ini kami tidak lagi membandingkan keduanya berdasarkan daftar fitur dan kesan umum saja.
Pada 22 Agustus 2026, kami menjalankan enam pengujian terkontrol menggunakan prompt yang sama pada kedua chatbot. Model yang terlihat pada antarmuka saat pengujian adalah Claude Sonnet 5 dengan mode Medium dan Gemini Flash. Paket akun persisnya tidak tercatat dalam bukti, sehingga hasil ini tidak boleh dibaca sebagai perbandingan paket berbayar tertentu.
Hasil akhirnya:
| Pengujian | Claude | Gemini |
|---|---|---|
| Menulis dengan constraint ketat | 23,0 / 25 | 20,0 / 25 |
| Analisis dokumen | 25,0 / 25 | 23,5 / 25 |
| Penalaran kuantitatif | 25,0 / 25 | 25,0 / 25 |
| Coding dan debugging | 25,0 / 25 | 24,0 / 25 |
| Perencanaan dengan constraint | 23,5 / 25 | 21,0 / 25 |
| Riset web dan kualitas sumber | 24,5 / 25 | 14,5 / 25 |
| Total | 146,0 / 150 | 128,0 / 150 |
Dalam test set ini, Claude memperoleh skor keseluruhan lebih tinggi. Selisih paling besar muncul pada pengujian riset web dan disiplin sumber. Namun, hasil ini bukan bukti bahwa Claude selalu lebih baik untuk semua orang atau semua tugas. Pada hitungan kuantitatif, keduanya memperoleh skor sempurna. Pada analisis dokumen dan coding, keduanya juga sama-sama kuat.
Jika Anda baru mengenal masing-masing produk, baca Claude untuk Pemula dan Gemini AI untuk Pemula. Artikel ini fokus pada perbandingan langsung, bukan tutorial dasar penggunaan.
Bagaimana Kami Menguji Claude dan Gemini
Agar perbandingannya lebih dapat diperiksa ulang, kami menggunakan aturan yang sama untuk kedua chatbot:
- setiap tugas dimulai dari fresh chat;
- prompt diberikan tanpa diubah antara Claude dan Gemini;
- jawaban pertama disimpan sebelum ada follow-up;
- file yang digunakan pada tes dokumen dibuat khusus untuk pengujian dan diberikan identik kepada kedua model;
- web hanya digunakan pada tes keenam;
- urutan model dibuat bergantian untuk mengurangi bias urutan;
- hasil dinilai pada lima dimensi: akurasi, kepatuhan instruksi, kelengkapan, kejelasan, dan penanganan evidence/ketidakpastian.
Urutan eksekusinya adalah Claude lebih dulu pada tes 1, 3, dan 5; Gemini lebih dulu pada tes 2, 4, dan 6.
Model yang terlihat di UI adalah Sonnet 5 Medium pada Claude dan Flash pada Gemini.
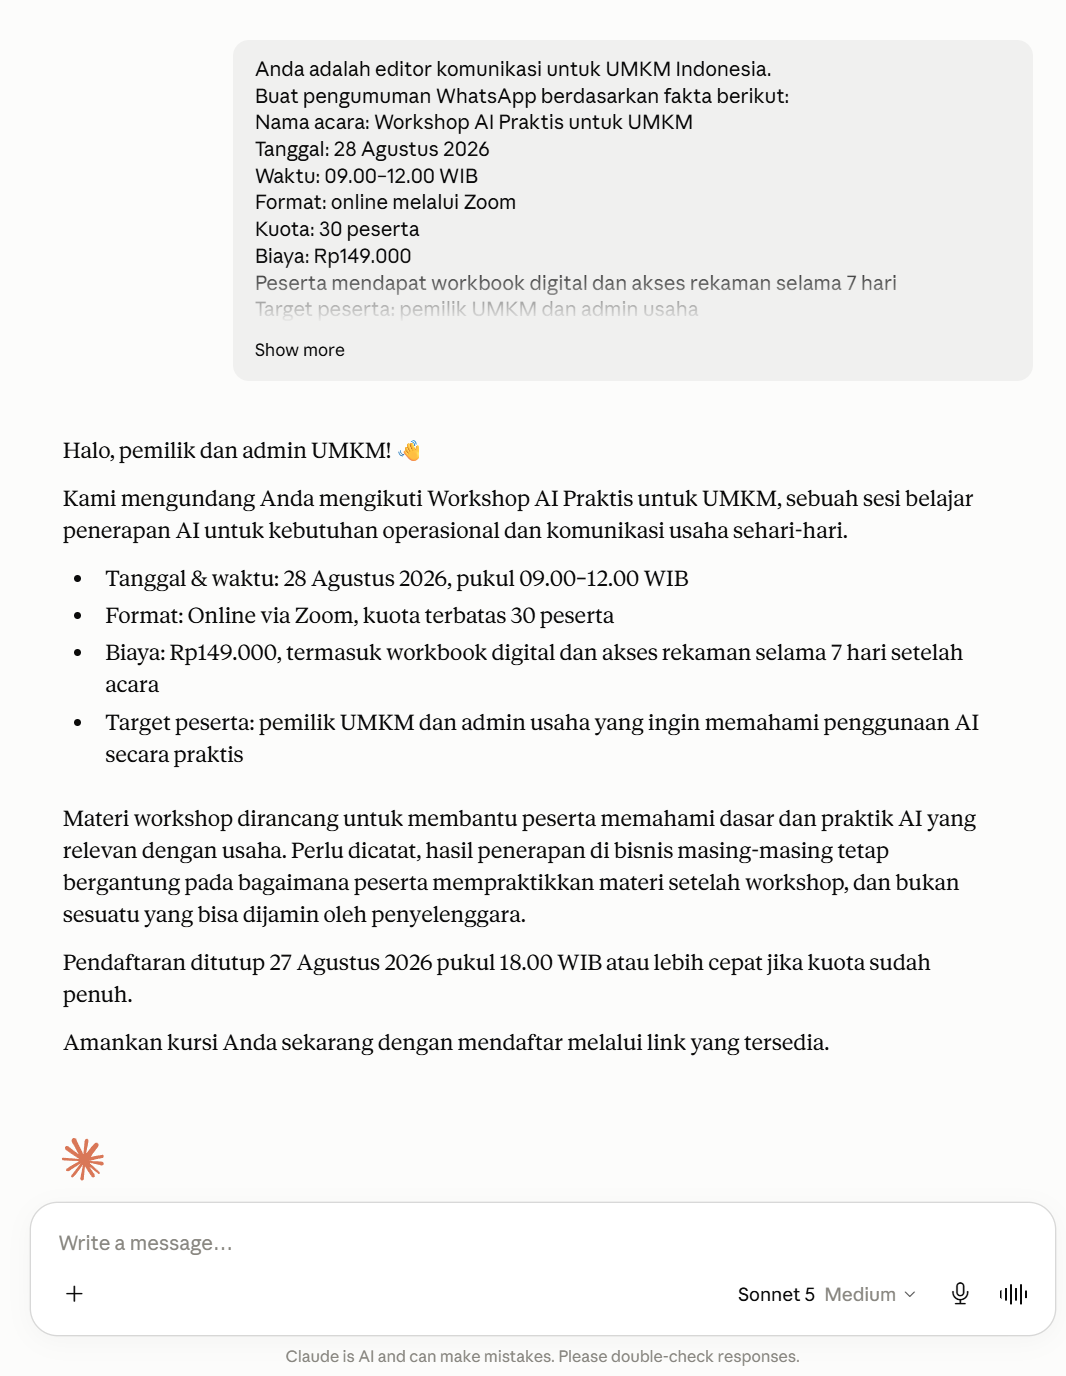
Model Claude yang terlihat saat pengujian: Sonnet 5 dengan mode Medium.
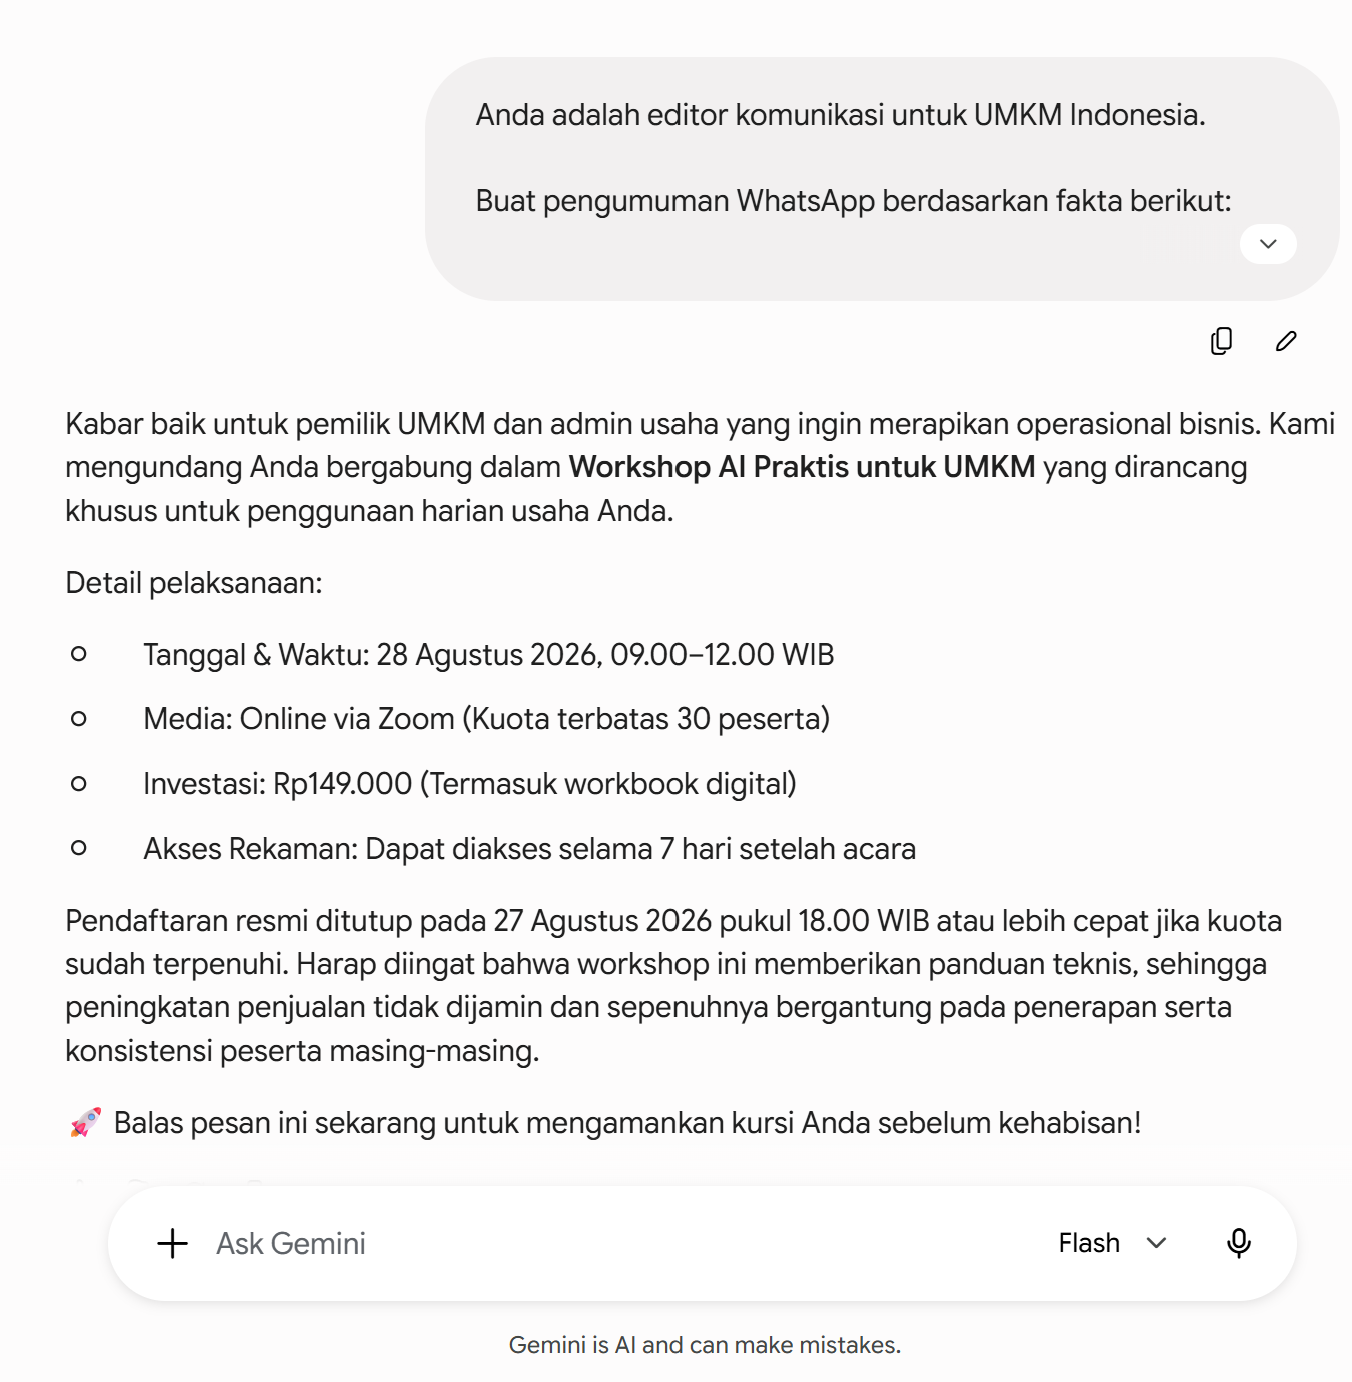
Model Gemini yang terlihat saat pengujian: Flash.
Ada dua data yang tidak kami rekam: paket akun persis dan waktu respons. Karena itu, artikel ini tidak menyimpulkan bahwa paket berbayar tertentu lebih unggul dan tidak membuat klaim tentang chatbot mana yang lebih cepat.
Skor 0–5 pada setiap dimensi juga bukan benchmark ilmiah universal. Skor digunakan agar evaluasi terhadap dua jawaban yang berasal dari prompt sama lebih konsisten.
Lima dimensi yang kami gunakan adalah accuracy/correctness, instruction adherence, completeness, clarity/usability, dan evidence/uncertainty handling. Dengan cara ini, jawaban yang terdengar meyakinkan tetapi melanggar constraint tidak otomatis mendapat nilai tinggi.
Kami juga memisahkan check yang bisa dihitung dari judgement manusia. Pada tes menulis kami menghitung jumlah kata dan bullet; pada tes dokumen kami menanam empat konflik yang sudah diketahui; pada tes matematika kami mempunyai hasil ground truth; pada tes coding kami memeriksa bug dan edge case yang spesifik; sedangkan pada tes riset kami membatasi domain sumber. Pendekatan ini tidak menghilangkan subjektivitas, tetapi membuat alasan pemberian skor lebih dapat ditelusuri.
Respons pertama dipertahankan sebagai evidence. Kami tidak meminta model memperbaiki jawabannya sebelum scoring karena kemampuan memperbaiki jawaban setelah diberi hint adalah kemampuan yang berbeda dari ketepatan respons pertama.
Kami juga tidak menyamakan semua selisih skor. Selisih 25 vs 24 pada coding berarti keduanya pada praktiknya menghasilkan solusi yang dapat dipakai; perbedaannya ada pada presisi penjelasan. Sebaliknya, selisih 24,5 vs 14,5 pada riset web berasal dari error freshness dan pelanggaran aturan sumber, sehingga lebih material untuk pekerjaan yang bergantung pada informasi terkini.
Untuk mengulang tes seperti ini sendiri, gunakan prompt yang identik, catat model dan tanggal, simpan respons pertama, dan tentukan ground truth sebelum melihat hasil bila memungkinkan. Hindari mengubah prompt setelah melihat jawaban satu model karena perbandingan menjadi tidak setara.
Test 1: Menulis Bahasa Indonesia dengan Constraint Ketat
Tes pertama meminta kedua model membuat pengumuman WhatsApp untuk workshop UMKM. Prompt sengaja memiliki beberapa batas yang mudah diverifikasi, antara lain:
- panjang 120–150 kata;
- tepat empat bullet;
- maksimal satu emoji;
- akses rekaman hanya tujuh hari;
- tidak membuat diskon, bonus, testimoni, atau klaim tambahan;
- harus menjelaskan bahwa hasil bisnis tidak dijamin;
- kalimat terakhir harus berupa CTA.
Hasil
Claude menghasilkan 138 kata, memenuhi empat bullet, satu emoji, ketentuan rekaman tujuh hari, disclaimer hasil bisnis, dan CTA terakhir.
Gemini menghasilkan 116 kata, sehingga gagal memenuhi batas minimum 120 kata. Struktur lainnya sebagian besar tetap dipenuhi.
Keduanya melakukan satu kesalahan yang menarik: mereka menambahkan mekanisme pendaftaran yang sebenarnya tidak tersedia di brief. Claude menulis seolah ada link pendaftaran, sedangkan Gemini mengarahkan pembaca untuk membalas pesan.
Itulah alasan Claude tidak mendapat skor sempurna walaupun lebih patuh pada struktur.
Skor: Claude 23,0; Gemini 20,0.
Pelajaran praktisnya: untuk pekerjaan copywriting yang memiliki banyak constraint, jangan hanya memeriksa apakah tulisannya terdengar bagus. Verifikasi juga panjang, format, CTA, angka, serta detail yang tidak boleh diada-adakan oleh AI.
Jika Anda sering bekerja dengan instruksi seperti ini, panduan Cara Membuat Prompt yang Baik dapat membantu menyusun batas yang lebih mudah diaudit.
Test 2: Analisis Dokumen dan Deteksi Konflik
Pada tes kedua kami memberikan dokumen operasional UMKM sintetis. Dokumen tersebut sengaja memuat empat konflik internal:
- jumlah staf;
- jam buka akhir pekan;
- anggaran campaign;
- SLA penyerahan delivery.
Kedua model diminta membuat sepuluh fakta utama, menemukan semua ketidakkonsistenan dengan menyebut bagian sumber, lalu memberikan tepat tiga pertanyaan klarifikasi untuk owner. Mereka juga dilarang memakai internet atau mengarang data di luar dokumen.
Hasil
Keduanya berhasil menemukan keempat konflik.
Claude lebih lengkap saat menjelaskan konflik staf. Ia menghubungkan baseline di Bagian A — 8 staf Dago + 6 Cimahi = 14 — dengan rencana Bagian E — 8 Dago + 7 Cimahi = 15 — sementara bagian yang sama tetap menyatakan jumlah staf total 14.
Gemini tetap menemukan konflik utama, tetapi penjelasannya lebih fokus pada 15 vs 14 di Bagian E sehingga konteks 6 vs 7 staf Cimahi dari Bagian A tidak ditarik sejelas Claude.
Gemini juga menyebut anggaran Rp6 juta sebagai “diajukan”, sedangkan dokumen menyatakan anggaran tersebut telah disetujui rapat marketing.
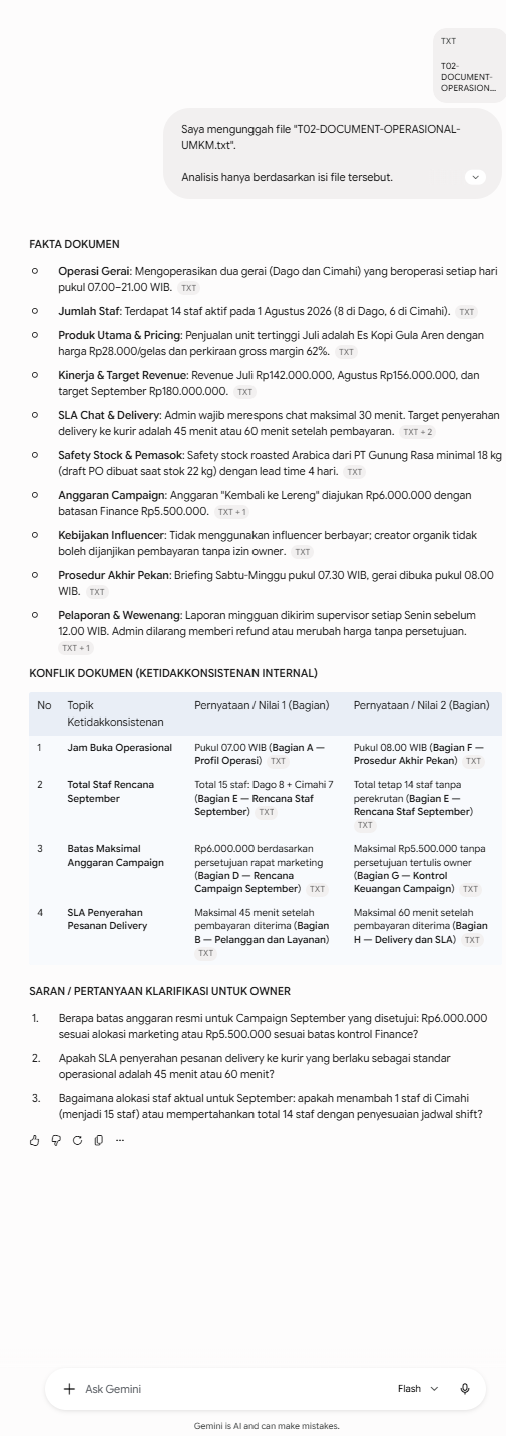
Gemini menemukan keempat konflik, tetapi uraian konflik stafnya lebih ringkas.
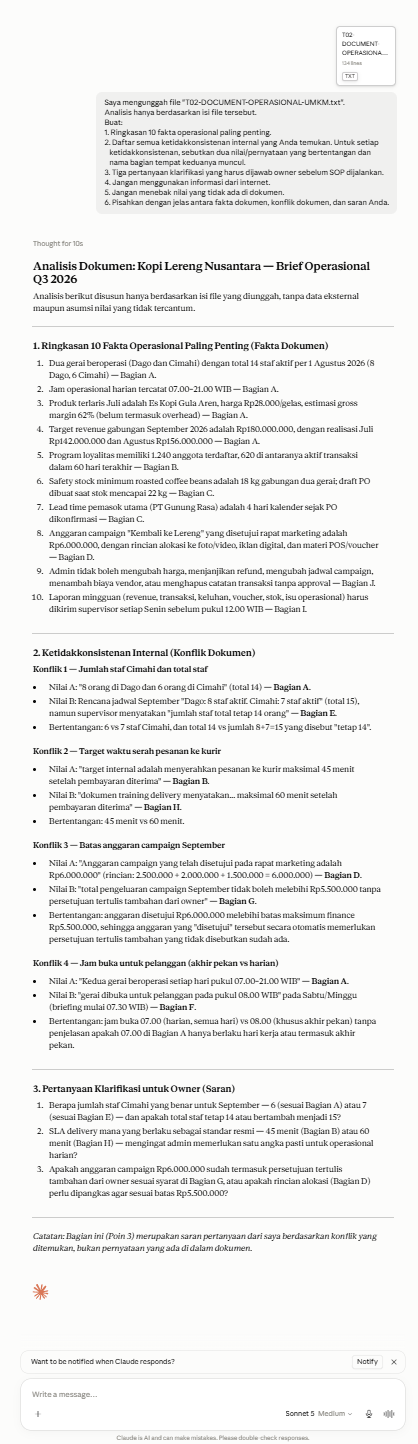
Claude menelusuri konflik staf hingga perbedaan jumlah staf Cimahi dan total keseluruhan.
Skor: Claude 25,0; Gemini 23,5.
Untuk penggunaan nyata, hasil ini menunjukkan mengapa AI sebaiknya diminta menunjukkan bagian sumber saat menganalisis SOP, kontrak, brief, atau dokumen internal. Jawaban “ada konflik” kurang berguna jika pengguna tidak dapat menelusuri dua pernyataan yang bertentangan.
Test 3: Hitungan AOV, Growth, Refund, dan Revenue Setelah Pengurangan
Tes ketiga menggunakan data tiga bulan yang sama untuk kedua model:
| Bulan | Orders | Revenue | Ad Spend | Refunds |
|---|---|---|---|---|
| May | 840 | Rp67.200.000 | Rp4.800.000 | Rp1.680.000 |
| June | 960 | Rp81.600.000 | Rp5.100.000 | Rp2.040.000 |
| July | 1.000 | Rp90.000.000 | Rp6.000.000 | Rp1.800.000 |
Mereka diminta menghitung AOV, pertumbuhan revenue, rasio ad spend, refund rate, serta revenue setelah dikurangi ad spend dan refunds. Prompt secara eksplisit melarang asumsi tentang profit, COGS, pajak, atau margin.
Hasil
Kedua model menghitung seluruh angka dengan benar:
- AOV: Rp80.000, Rp85.000, Rp90.000;
- growth: 21,43% dan 10,29%;
- ad spend/revenue: 7,14%, 6,25%, 6,67%;
- refunds/revenue: 2,50%, 2,50%, 2,00%;
- revenue setelah ad spend dan refunds: Rp60,72 juta, Rp74,46 juta, Rp82,20 juta;
- July menjadi bulan dengan nilai terakhir tertinggi.
Keduanya juga menampilkan rumus dan mengikuti pembulatan dua desimal.
Claude menambahkan catatan bahwa angka setelah pengurangan tersebut bukan profit atau margin karena biaya lain tidak tersedia. Gemini menyajikan hasil akhir dalam tabel ringkas. Keduanya sama-sama valid, sehingga tidak ada alasan kuat untuk memisahkan skor.
Skor: Claude 25,0; Gemini 25,0.
Ini menjadi pengingat bahwa benchmark sederhana sering menghasilkan hasil imbang. Jangan memaksakan pemenang ketika evidence tidak menunjukkan perbedaan nyata.
Test 4: Coding dan Debugging JavaScript
Kode awal pada tes keempat sengaja memiliki beberapa bug:
function summarizeOrders(orders) {
  const paid = orders.filter(order => order.status = "paid");
  const revenue = paid.reduce((sum, order) => sum + order.total, 0);
  const average = revenue / orders.length;
  const top = paid.sort((a, b) => a.total - b.total)[0];

  return {
    count: paid.length,
    revenue,
    average,
    topId: top.id
  };
}
Kedua model harus menemukan bahwa:
order.status = "paid"adalah assignment, bukan comparison;- assignment tersebut memutasi status object input;
- average seharusnya membagi dengan
paid.length; - sort ascending lalu mengambil elemen
[0]memilih total terkecil; - kondisi tanpa paid order membuat
topundefined; - hasil no-paid harus
count=0,revenue=0,average=0,topId=null; - solusi tidak boleh memutasi input;
- minimal empat test case harus disediakan.
Hasil
Kedua model menghasilkan fungsi yang secara substantif benar. Mereka menggunakan ===, menghitung average dari paid orders, menangani zero-paid, dan mencari order dengan total terbesar.
Claude memberi enam test case, termasuk mixed status, zero-paid, array kosong, immutability, dan nilai tertinggi yang seri.
Gemini juga memenuhi requirement utama, tetapi penjelasannya sedikit mengaburkan satu detail JavaScript. Ia menempatkan sort() sebagai salah satu alasan kode awal mengubah data input. Memang benar sort() bersifat in-place, tetapi pada kode itu ia dipanggil pada paid, yaitu array baru hasil filter, bukan langsung pada array orders. Mutasi object input yang material berasal dari assignment order.status = "paid".
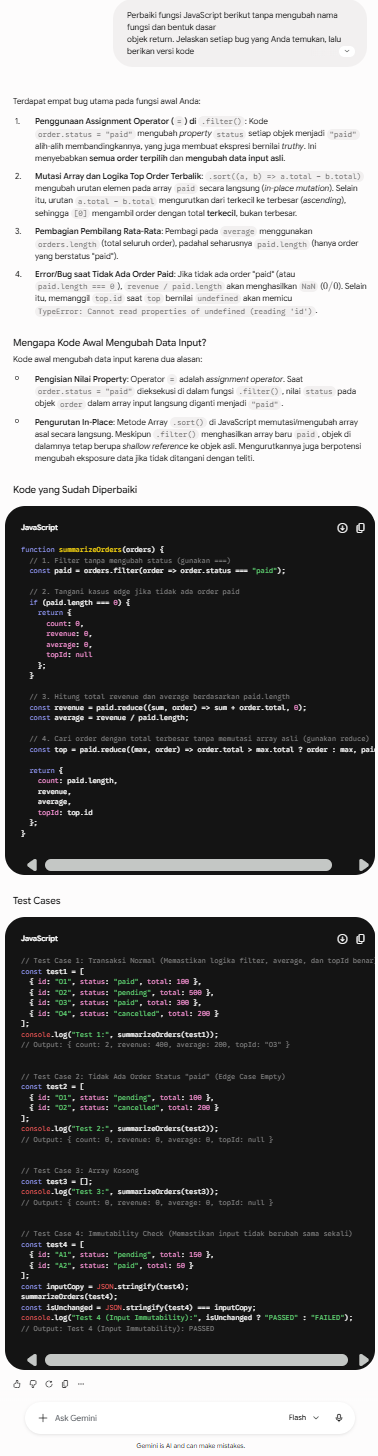
Solusi Gemini benar, dengan sedikit ketidakpresisian pada penjelasan mutasi array.
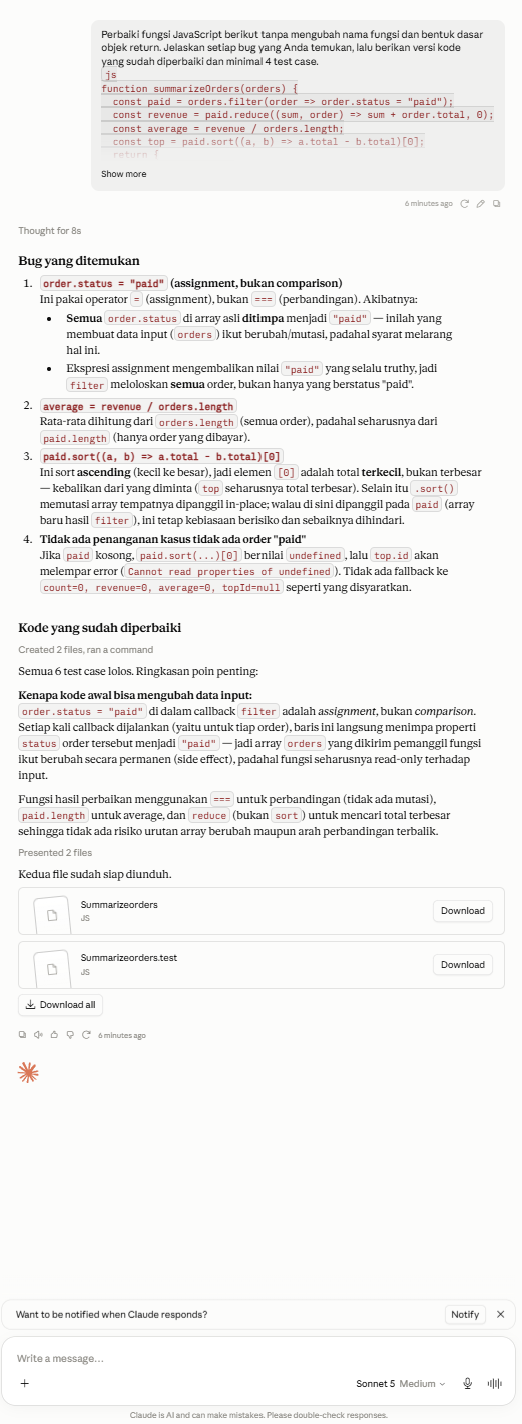
Claude memperbaiki fungsi dan menyertakan enam test case, termasuk pemeriksaan immutability.
Skor: Claude 25,0; Gemini 24,0.
Perbedaan satu poin ini lebih mencerminkan presisi penjelasan daripada kemampuan memperbaiki kode. Solusi final keduanya bisa digunakan setelah review manusia.
Test 5: Merancang Eksperimen AI untuk UMKM dengan Banyak Batasan
Tes kelima lebih dekat ke situasi operasional nyata. Sebuah UMKM memiliki dua admin, maksimal enam jam per minggu untuk eksperimen AI, anggaran tool baru maksimal Rp900.000 per bulan, belum siap membeli CRM, tidak mengizinkan AI mengirim pesan otomatis, dan mewajibkan human review untuk semua output yang dilihat pelanggan.
Model diminta memilih tepat dua eksperimen selama 14 hari serta mendefinisikan baseline, workflow, waktu, biaya, metrik, stop criterion, risiko, dan checkpoint manusia.
Hasil
Keduanya memilih dua arah yang relevan:
- AI membantu membuat draft balasan pelanggan;
- AI membantu membuat sistem/draft konten agar brand voice lebih konsisten.
Claude mengalokasikan total 5 jam per minggu, menyisakan buffer satu jam. Baseline-nya mencakup beberapa hari data response time, FAQ, editing rate, serta penilaian konsistensi konten. Human review ditempatkan sebelum pengiriman atau publikasi.
Gemini menggunakan tepat 6 jam per minggu, sehingga masih memenuhi batas tetapi tanpa buffer. Rencananya tetap operasional dan menjaga manual send/human review.
Kekurangan Gemini berada pada asumsi produk dan harga. Ia menyebut contoh tier seperti “ChatGPT Pro / Claude Pro / Gemini Advanced” serta angka harga tertentu tanpa web verification. Karena tes ini tidak menggunakan internet, nama paket dan harga semestinya ditulis sebagai estimasi atau budget allowance, bukan fakta terkini.
Claude juga mencantumkan angka biaya tool tanpa sumber, sehingga tetap kami kurangi. Bedanya, struktur baseline, buffer, dan pengendalian eksperimennya lebih kuat.
Skor: Claude 23,5; Gemini 21,0.
Bagi UMKM, bagian terpenting dari rencana seperti ini bukan nama tool, melainkan apakah ada baseline, target yang terukur, trigger berhenti, serta kontrol manusia sebelum output AI menyentuh pelanggan.
Untuk konteks penerapan AI di usaha, lihat juga AI untuk Bisnis dan AI Chatbot untuk Bisnis.
Test 6: Riset Web Terkini dan Disiplin Sumber
Tes terakhir memberi selisih skor terbesar.
Kedua model diminta menggunakan web untuk memeriksa kondisi terkini pada 22 Agustus 2026. Sumber dibatasi hanya ke halaman resmi Anthropic/Claude dan Google. Mereka harus memeriksa model default Claude, paket individual, context window, pilihan model Gemini, paket Google AI, serta disclaimer perubahan model dan limit.
Hasil Claude
Claude menyebut Sonnet 5 sebagai default Free dan Pro, sesuai pengumuman resmi Anthropic. Anthropic menyatakan Sonnet 5 tersedia di semua paket dan menjadi default untuk Free serta Pro. Sumber resmi Anthropic.
Claude juga menangkap satu detail penting yang mudah disederhanakan secara salah:
- tabel perbandingan individual di Claude Pricing menampilkan 200k pada baris context window untuk Free, Pro, Max 5x, dan Max 20x;
- Claude Help Center menjelaskan bahwa Sonnet 5 dan Opus 5 mendukung 1M token pada semua paid plans saat chatting dengan Claude.
Dua angka itu berasal dari dua lapisan dokumentasi resmi yang berbeda. Karena pertanyaan tes secara eksplisit meminta angka yang ditampilkan pada pricing page, jawaban yang baik perlu menyebut 200k sekaligus menjelaskan dokumentasi model-specific 1M, bukan mengganti salah satunya diam-diam.
Untuk Gemini, Claude menggunakan halaman resmi dan membedakan penamaan model yang berubah antar-product surface. Google sendiri memperingatkan bahwa nama model, versi, availability, dan limit dapat berubah.
Google saat ini menawarkan tiga paket konsumen utama: Google AI Plus, Google AI Pro, dan Google AI Ultra. Lihat paket Google AI resmi untuk Indonesia.
Untuk detail Gemini Apps dan limit, rujuk Gemini Apps Help. Pada evidence pengujian, tabel Help menunjukkan context window 32k tanpa paket AI, 128k untuk AI Plus, dan 1 juta token untuk AI Pro/Ultra.
Hasil Gemini
Gemini mendapatkan struktur paket Google AI dan angka context window tersebut dengan benar. Namun, ada dua masalah besar.
Pertama, Gemini menyatakan default Claude Free/Pro masih Claude 3.5 Sonnet. Itu sudah stale pada tanggal pengujian.
Kedua, Gemini menyebut pilihan utama Gemini sebagai Gemini 1.5/2.0 Flash dan 1.5/2.0 Pro, serta “Advanced / Deep Think Mode”. Ini tidak sesuai dengan taxonomy model pada ground truth resmi yang kami gunakan untuk tanggal pengujian.
Selain itu, screenshot jawaban Gemini memperlihatkan attribution ke sumber pihak ketiga pada sebagian klaim, padahal prompt secara eksplisit hanya mengizinkan sumber resmi.
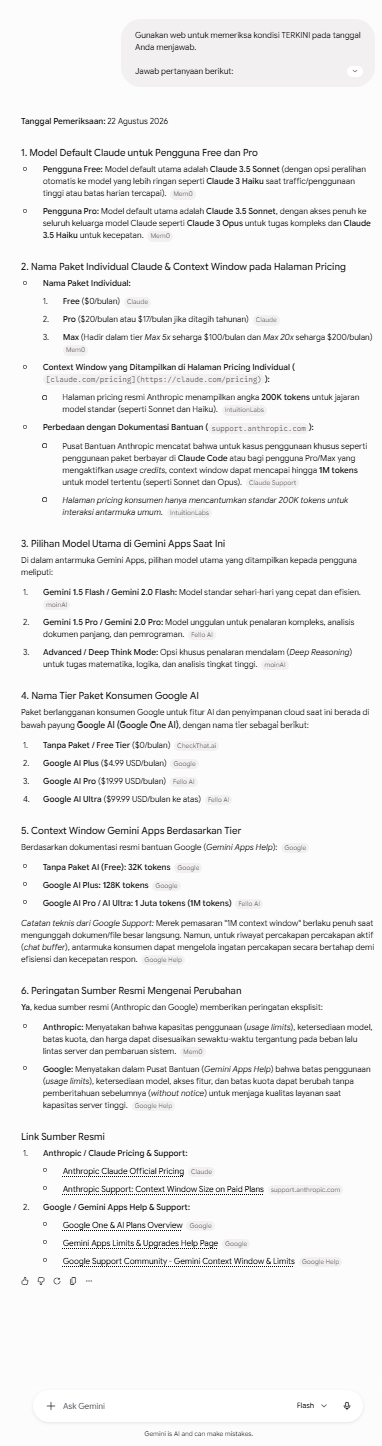
Jawaban Gemini memuat informasi model yang stale dan atribusi pihak ketiga meskipun sumber dibatasi ke domain resmi.
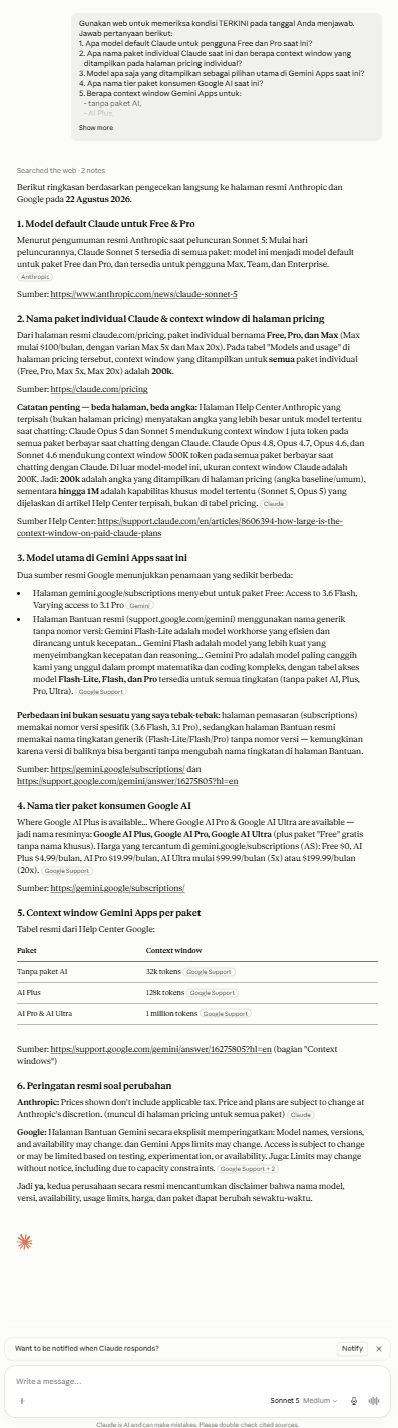
Jawaban Claude menggunakan sumber resmi dan membedakan angka 200k pada pricing page dari dokumentasi model-specific 1M.
Skor: Claude 24,5; Gemini 14,5.
Temuan ini tidak berarti Gemini secara umum “buruk untuk riset”. Klaim yang lebih tepat adalah: pada satu pengujian riset web dengan aturan official-sources-only pada 22 Agustus 2026, jawaban Gemini Flash yang kami terima lebih stale dan kurang disiplin terhadap batas sumber dibanding Claude Sonnet 5 Medium.
Fitur dan Paket: Jangan Campur dengan Skor Benchmark
Skor enam tes di atas mengukur respons yang kami terima pada tugas tertentu. Skor itu tidak menggantikan perbandingan fitur produk.
Claude dan Gemini sama-sama berkembang cepat. Nama model, limit, plan, dan fitur dapat berubah setelah artikel ini diperbarui.
Untuk Claude, halaman pricing individual saat pembaruan ini menampilkan paket Free, Pro, dan Max. Anthropic juga menyatakan harga dan paket dapat berubah. Detail terkini sebaiknya selalu diperiksa di Claude Pricing.
Untuk Google, paket konsumen yang ditampilkan adalah Google AI Plus, Google AI Pro, dan Google AI Ultra. Halaman produk Google untuk Indonesia juga menunjukkan bahwa tingkat akses, storage, dan fitur berbeda antar-tier. Lihat Google AI Plans.
Halaman langganan Gemini untuk Indonesia dapat menampilkan nama model yang lebih spesifik atau versioned daripada label generik di Help Center. Untuk mengecek perubahan model di Gemini Apps, gunakan juga dokumentasi resmi model Gemini Apps. Karena Google sendiri menyatakan nama model, versi, dan availability dapat berubah, artikel ini sengaja tidak menjadikan satu nama versi sebagai fakta permanen.
Perbedaan fitur ekosistem juga tidak kami masukkan ke skor enam tes. Integrasi Google dengan Gmail, Docs, Drive, dan layanan lain dapat menjadi alasan praktis memilih Gemini, tetapi keuntungan integrasi tersebut berbeda dari kualitas jawaban pada prompt terkontrol. Demikian pula fitur Claude seperti connectors, web search, projects, atau tools lain perlu dinilai berdasarkan workflow pengguna, bukan diasumsikan dari skor benchmark ini.
Jika kebutuhan Anda adalah onboarding, akses akun, atau penjelasan fitur dasar, gunakan panduan Claude untuk Pemula dan Gemini AI untuk Pemula daripada menjadikan artikel perbandingan ini sebagai tutorial dasar.
Claude Lebih Cocok untuk Siapa Berdasarkan Tes Ini?
Berdasarkan test set ini, Claude lebih menarik jika pekerjaan Anda banyak melibatkan:
- instruksi dengan constraint yang ketat;
- membaca dokumen dan menelusuri konflik antarbagian;
- debugging yang membutuhkan penjelasan teknis presisi;
- perencanaan operasional dengan beberapa batas sekaligus;
- riset web yang menuntut disiplin sumber primer.
Kata kuncinya adalah berdasarkan tes ini. Kami tidak menguji semua jenis pekerjaan, model, integrasi, atau konfigurasi.
Jika fokus utama Anda justru membandingkan Claude dengan ChatGPT, baca Claude vs ChatGPT. Itu merupakan intent berbeda dan tidak dibahas ulang di sini.
Gemini Lebih Cocok untuk Siapa Berdasarkan Tes Ini?
Gemini tetap memberi hasil kuat pada beberapa tugas.
Pada tes hitungan, Gemini memperoleh skor sempurna. Pada analisis dokumen, ia menemukan seluruh konflik utama. Pada coding, solusi akhirnya juga benar dan memenuhi edge case utama.
Karena itu, Gemini tetap layak dipertimbangkan jika:
- Anda membutuhkan chatbot serbaguna untuk hitungan dan pengolahan informasi;
- workflow Anda sudah banyak berada di ekosistem Google;
- Anda nyaman melakukan verifikasi tambahan untuk informasi yang sangat time-sensitive;
- Anda bersedia memeriksa kembali citation dan tanggal ketika tugas membutuhkan riset web terkini.
Untuk pilihan chatbot yang lebih luas, lihat AI Chatbot Terbaik.
Ringkasan praktis dari enam tes kami:
| Kebutuhan | Hasil test set ini | Catatan |
|---|---|---|
| Menulis dengan aturan ketat | Claude unggul | Gemini melanggar minimum word count; keduanya menambah mekanisme daftar |
| Analisis dokumen | Claude unggul tipis | Keduanya menemukan 4/4 konflik |
| Hitungan | Imbang | Keduanya 25/25 |
| Debugging JavaScript | Claude unggul tipis | Kode keduanya benar; beda pada presisi explanation |
| Perencanaan UMKM | Claude unggul | Claude menyisakan buffer waktu dan baseline lebih kuat |
| Riset web sumber resmi | Claude unggul jelas | Gemini membawa info stale dan sumber pihak ketiga pada test ini |
Tabel tersebut adalah decision aid, bukan ranking universal. Jika kebutuhan utama Anda adalah fitur Workspace, misalnya, benchmark prompt ini belum mengukur manfaat integrasi Google secara langsung.
Keterbatasan Pengujian Ini
Agar hasilnya tidak dibaca lebih jauh daripada evidence, berikut batas pengujiannya.
Pertama, hanya satu model label per platform yang diuji. Claude menggunakan Sonnet 5 Medium dan Gemini menggunakan Flash sebagaimana terlihat pada UI. Hasil dapat berbeda pada model lain.
Kedua, exact account plan tidak tercatat. Kami tidak mengklaim perbandingan Free vs Pro, Pro vs Ultra, atau paket berbayar lain berdasarkan skor ini.
Ketiga, response time tidak direkam. Artikel ini tidak menyimpulkan mana yang lebih cepat.
Keempat, enam tugas bukan benchmark universal. Test set dipilih untuk mewakili kebutuhan praktis pengguna Indonesia: menulis, dokumen, angka, coding, perencanaan, dan riset.
Kelima, skor melibatkan evaluasi manusia. Kami menggunakan rubric yang sama, tetapi penilaian kualitas tetap memiliki unsur judgement. Karena itu, kami juga mempertahankan check yang objektif seperti word count, jumlah konflik, hasil matematika, bug yang ditemukan, constraint operasional, dan sumber yang digunakan.
Keenam, produk AI berubah cepat. Informasi model, paket, context window, harga, dan limit yang benar pada 22 Agustus 2026 dapat berubah. Selalu cek halaman resmi sebelum membuat keputusan pembelian atau workflow jangka panjang.
Jadi, Claude atau Gemini yang Lebih Baik?
Untuk enam tugas yang kami jalankan pada 22 Agustus 2026, Claude Sonnet 5 Medium unggul dengan 146/150 dibanding Gemini Flash 128/150.
Namun angka total tidak menceritakan seluruh cerita.
- Untuk penalaran kuantitatif, hasilnya imbang.
- Untuk analisis dokumen dan coding, keduanya kuat.
- Untuk writing constraint dan planning, Claude lebih konsisten dalam test set ini.
- Untuk riset web dengan sumber resmi, Claude memiliki keunggulan terbesar pada pengujian kami.
Jadi pilihan praktisnya bukan “chatbot mana yang menang selamanya”, melainkan chatbot mana yang lebih cocok untuk jenis pekerjaan Anda dan seberapa disiplin Anda memverifikasi outputnya.
Untuk pengguna yang hanya ingin satu rekomendasi dari test set ini, Claude lebih aman dipilih ketika pekerjaan utama Anda mirip dengan tugas yang kami uji: constraint kompleks, dokumen, debugging, planning, dan riset sumber primer. Namun jika workflow Anda sangat bergantung pada integrasi Google, keputusan tidak seharusnya dibuat dari skor prompt saja. Uji workflow yang benar-benar Anda pakai—misalnya Docs, Gmail, Drive, atau kebutuhan kolaborasi—dengan data non-sensitif sebelum memutuskan.
Cara praktis lainnya adalah membuat mini benchmark pribadi berisi tiga sampai lima tugas yang benar-benar sering Anda lakukan. Gunakan input yang sama, tentukan kriteria sukses, lalu catat berapa banyak koreksi manusia yang diperlukan. Benchmark personal seperti ini sering lebih berguna daripada ranking umum karena kualitas AI sangat dipengaruhi konteks pekerjaan, model, fitur yang aktif, dan kualitas prompt.
Jika pekerjaan Anda bergantung pada fakta terkini, selalu periksa sumber primer. Jika pekerjaan Anda melibatkan data pelanggan, dokumen internal, keputusan keuangan, atau tindakan yang berdampak pada orang lain, gunakan AI sebagai alat bantu dan pertahankan review manusia.
FAQ Claude vs Gemini
Apakah Claude lebih baik daripada Gemini?
Dalam enam tes terkontrol kami pada 22 Agustus 2026, Claude Sonnet 5 Medium memperoleh skor lebih tinggi daripada Gemini Flash. Hasil tersebut hanya berlaku pada model, prompt, dan kondisi pengujian ini; bukan klaim universal bahwa Claude selalu lebih baik.
Mana yang lebih baik untuk coding?
Pada tes debugging JavaScript kami, keduanya menghasilkan kode yang benar. Claude mendapat 25/25 dan Gemini 24/25 karena ada sedikit ketidakpresisian pada penjelasan mutation, bukan karena solusi akhir Gemini gagal.
Mana yang lebih baik untuk analisis dokumen?
Keduanya menemukan empat konflik yang sengaja ditanam pada dokumen uji. Claude menjelaskan konflik staf dengan lebih lengkap, sehingga skornya 25/25 dibanding Gemini 23,5/25.
Mana yang lebih baik untuk hitungan?
Pada tes kuantitatif kami, keduanya mendapat 25/25. Semua AOV, growth, ad-spend ratio, refund ratio, dan pengurangan revenue dihitung dengan benar.
Apakah Gemini kalah karena kami memakai model Flash?
Kami tidak menguji model Gemini lain dalam test set ini, jadi artikel ini tidak boleh menyimpulkan bagaimana hasilnya jika menggunakan model berbeda. Evidence hanya mendukung perbandingan Gemini Flash yang diuji dengan Claude Sonnet 5 Medium yang diuji.
Apakah hasil ini akan tetap sama beberapa bulan lagi?
Belum tentu. Kedua produk berubah cepat. Model, fitur, paket, availability, dan limit dapat berubah. Karena itu artikel mencantumkan tanggal pengujian dan mengarahkan pembaca ke sumber resmi untuk informasi yang time-sensitive.
Artikel Terkait
- Claude untuk Pemula
- Gemini AI untuk Pemula
- Claude vs ChatGPT
- AI Chatbot Terbaik
- Cara Membuat Prompt yang Baik
- Pusat AI Chatbot
Pelajari Lebih Lanjut
Jelajahi seluruh artikel dalam kategori AI Chatbot.
Lihat Semua Artikel AI Chatbot